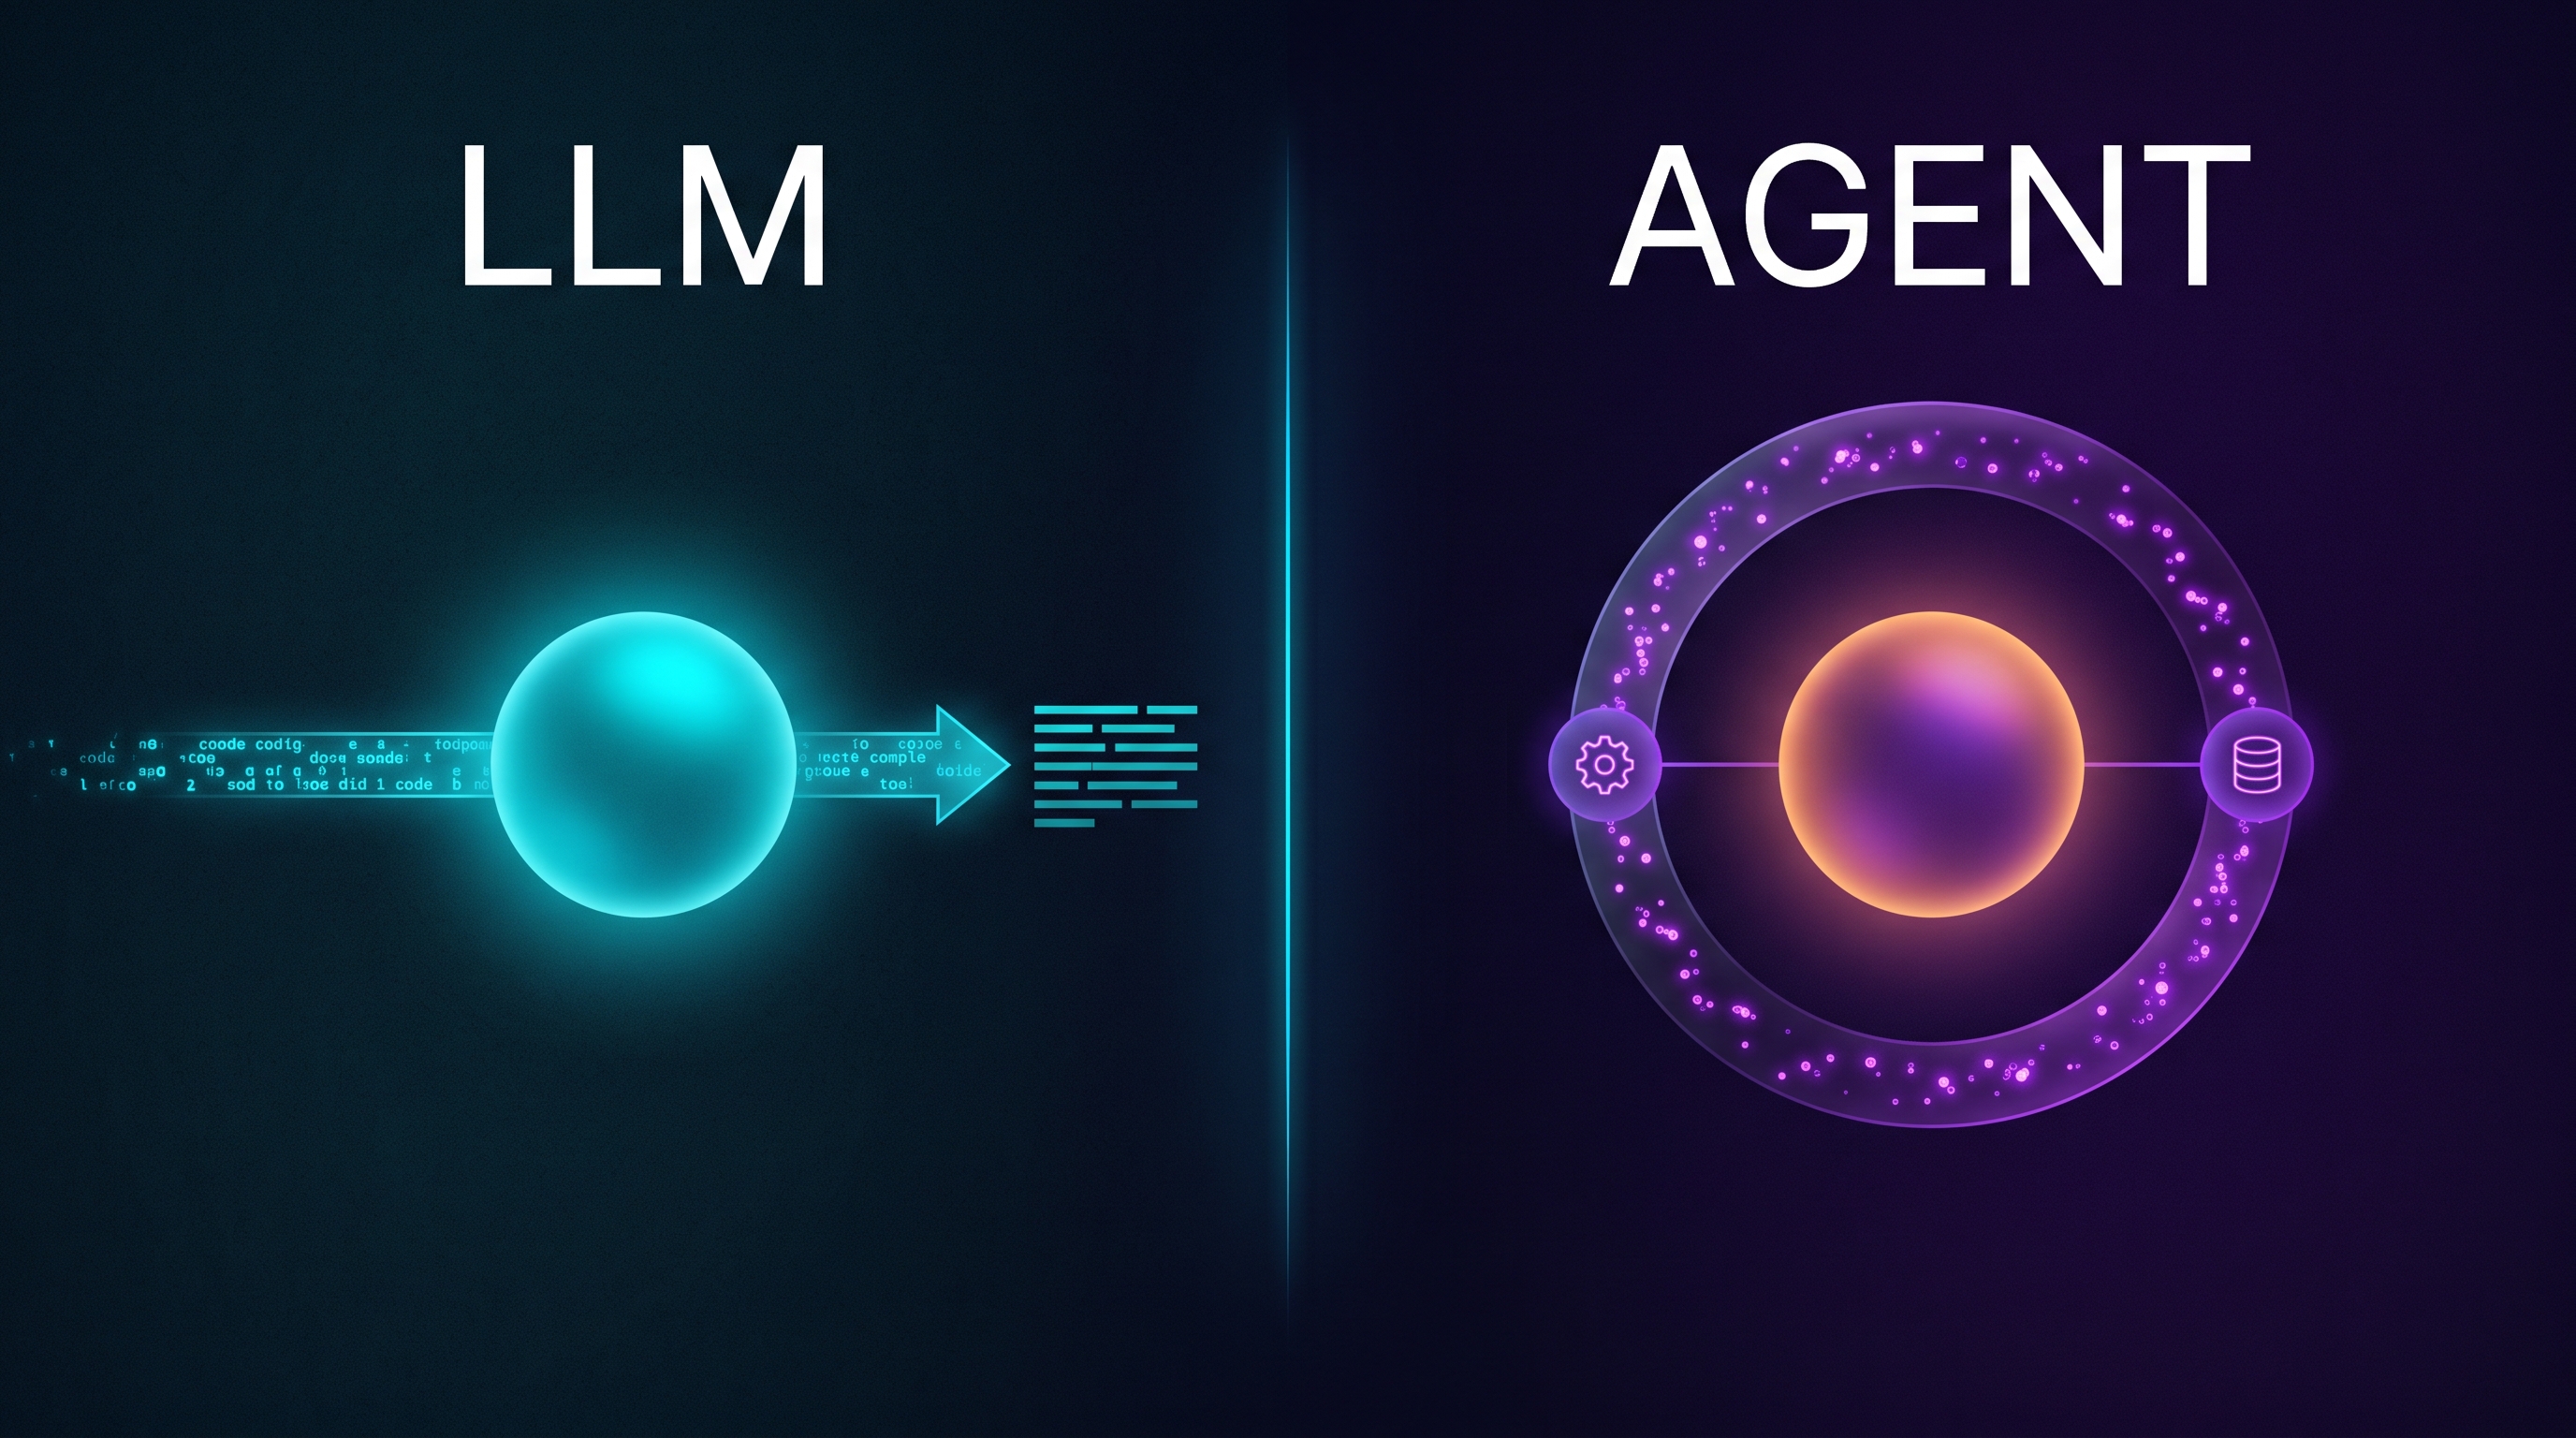
আগের পোস্টে AI Agent আসলে কী এবং কেন হঠাৎ সবাই এই নিয়ে কথা বলছে সেটা নিয়ে লিখেছিলাম। সেখানে একটা জিনিস ইচ্ছাকৃতভাবে দ্রুত পার হয়ে গিয়েছিলাম, যেটা আসলে নতুনদের সবচেয়ে বেশি confuse করে: LLM আর AI Agent এক জিনিস না, যদিও চলতি আলোচনায় দুটো শব্দ প্রায় সমার্থক হিসেবে ব্যবহার হয়।
LLM একটা text-prediction engine — একটা prompt পাঠালে সেটা একটা completion ফিরিয়ে দেয়, তারপর interaction শেষ। AI Agent হলো সেই LLM-কে ঘিরে বানানো একটা system, যেটা model-কে action নিতে দেয়, সেই action-এর result দেখতে দেয়, আর তার ভিত্তিতে পরের সিদ্ধান্ত নিতে দেয় — এই চক্র চলতে থাকে যতক্ষণ না কাজটা আসলেই শেষ হয়। প্রতিটা agent-এর ভেতরেই কোথাও একটা LLM থাকে। কিন্তু একটা chat UI-এর ভেতর থেকে LLM-কে কয়েকবার call করলেই সেটা agent হয়ে যায় না।
এই গুলিয়ে ফেলাটা কেন এত common
একটা কারণ marketing। যেই মুহূর্তে investor-রা "agent" শব্দটা শুনতে চাইলো, সেই মুহূর্তে প্রতিটা chatbot, প্রতিটা RAG pipeline, প্রতিটা Zapier automation রাতারাতি "AI Agent" নামে rebrand হয়ে গেল। আরেকটা কারণ — বাইরে থেকে দেখলে একটা ভালো agent আর একটা ভালো chatbot একই রকম দেখায়। দুটোই একটা message নেয়, একটা useful response ফিরিয়ে দেয়।
ধরো, একটা customer support bot যেটা শুধু FAQ database থেকে answer টেনে দেয় — এটা LLM ব্যবহার করছে, কিন্তু agent না, কারণ এটা কখনো কিছুর উপর action নেয় না, শুধু retrieve করে আর rephrase করে। আর একটা support bot যেটা একটা order-এর status একটা API থেকে check করে, নিজেই decide করে refund issue করা লাগবে কিনা, তারপর সেই action নেয় — এটাই আসলে agent behavior, কারণ এটা act করেছে, result দেখেছে, আর আবার decide করেছে।
LLM আসলে কী করে — আর কোথায় থেমে যায়
Framework আর product-এর নাম বাদ দিয়ে দেখলে, LLM মূলত একটা function। তুমি একটা sequence of tokens দিলে, সেটা পরের token-গুলো predict করে, আর যখন মনে করে response শেষ, তখন থেমে যায়। এইটুকুই। আগের message-টা মনে রাখে না, যদি না তুমি নিজেই সেটা নতুন prompt-এ paste করে দাও। নিজের answer সঠিক কিনা সেটা check করতে পারে না। নিজে থেকে কিছু lookup করতে পারে না, যদি না তুমি সেই lookup নিজে হাতে বানিয়ে না দিয়ে থাকো। একটা raw LLM call একটা single round trip — input যায়, text আসে, শেষ।
এটা কোনো ভুলে থাকা limitation না — একটা language model আসলে এভাবেই কাজ করে। মানুষ যে "intelligence"-এর কথা বলে, সেটা পুরোপুরি নির্ভর করে আগের সব context দেখে পরের token কতটা ভালোভাবে predict করতে পারছে তার উপর। এর মধ্যে world-এর উপর action নেওয়া বা একাধিক response জুড়ে একটা decision চালিয়ে যাওয়ার মতো কিছুই নেই।
LLM থেকে Agent বানায় আসলে কোন জিনিসটা
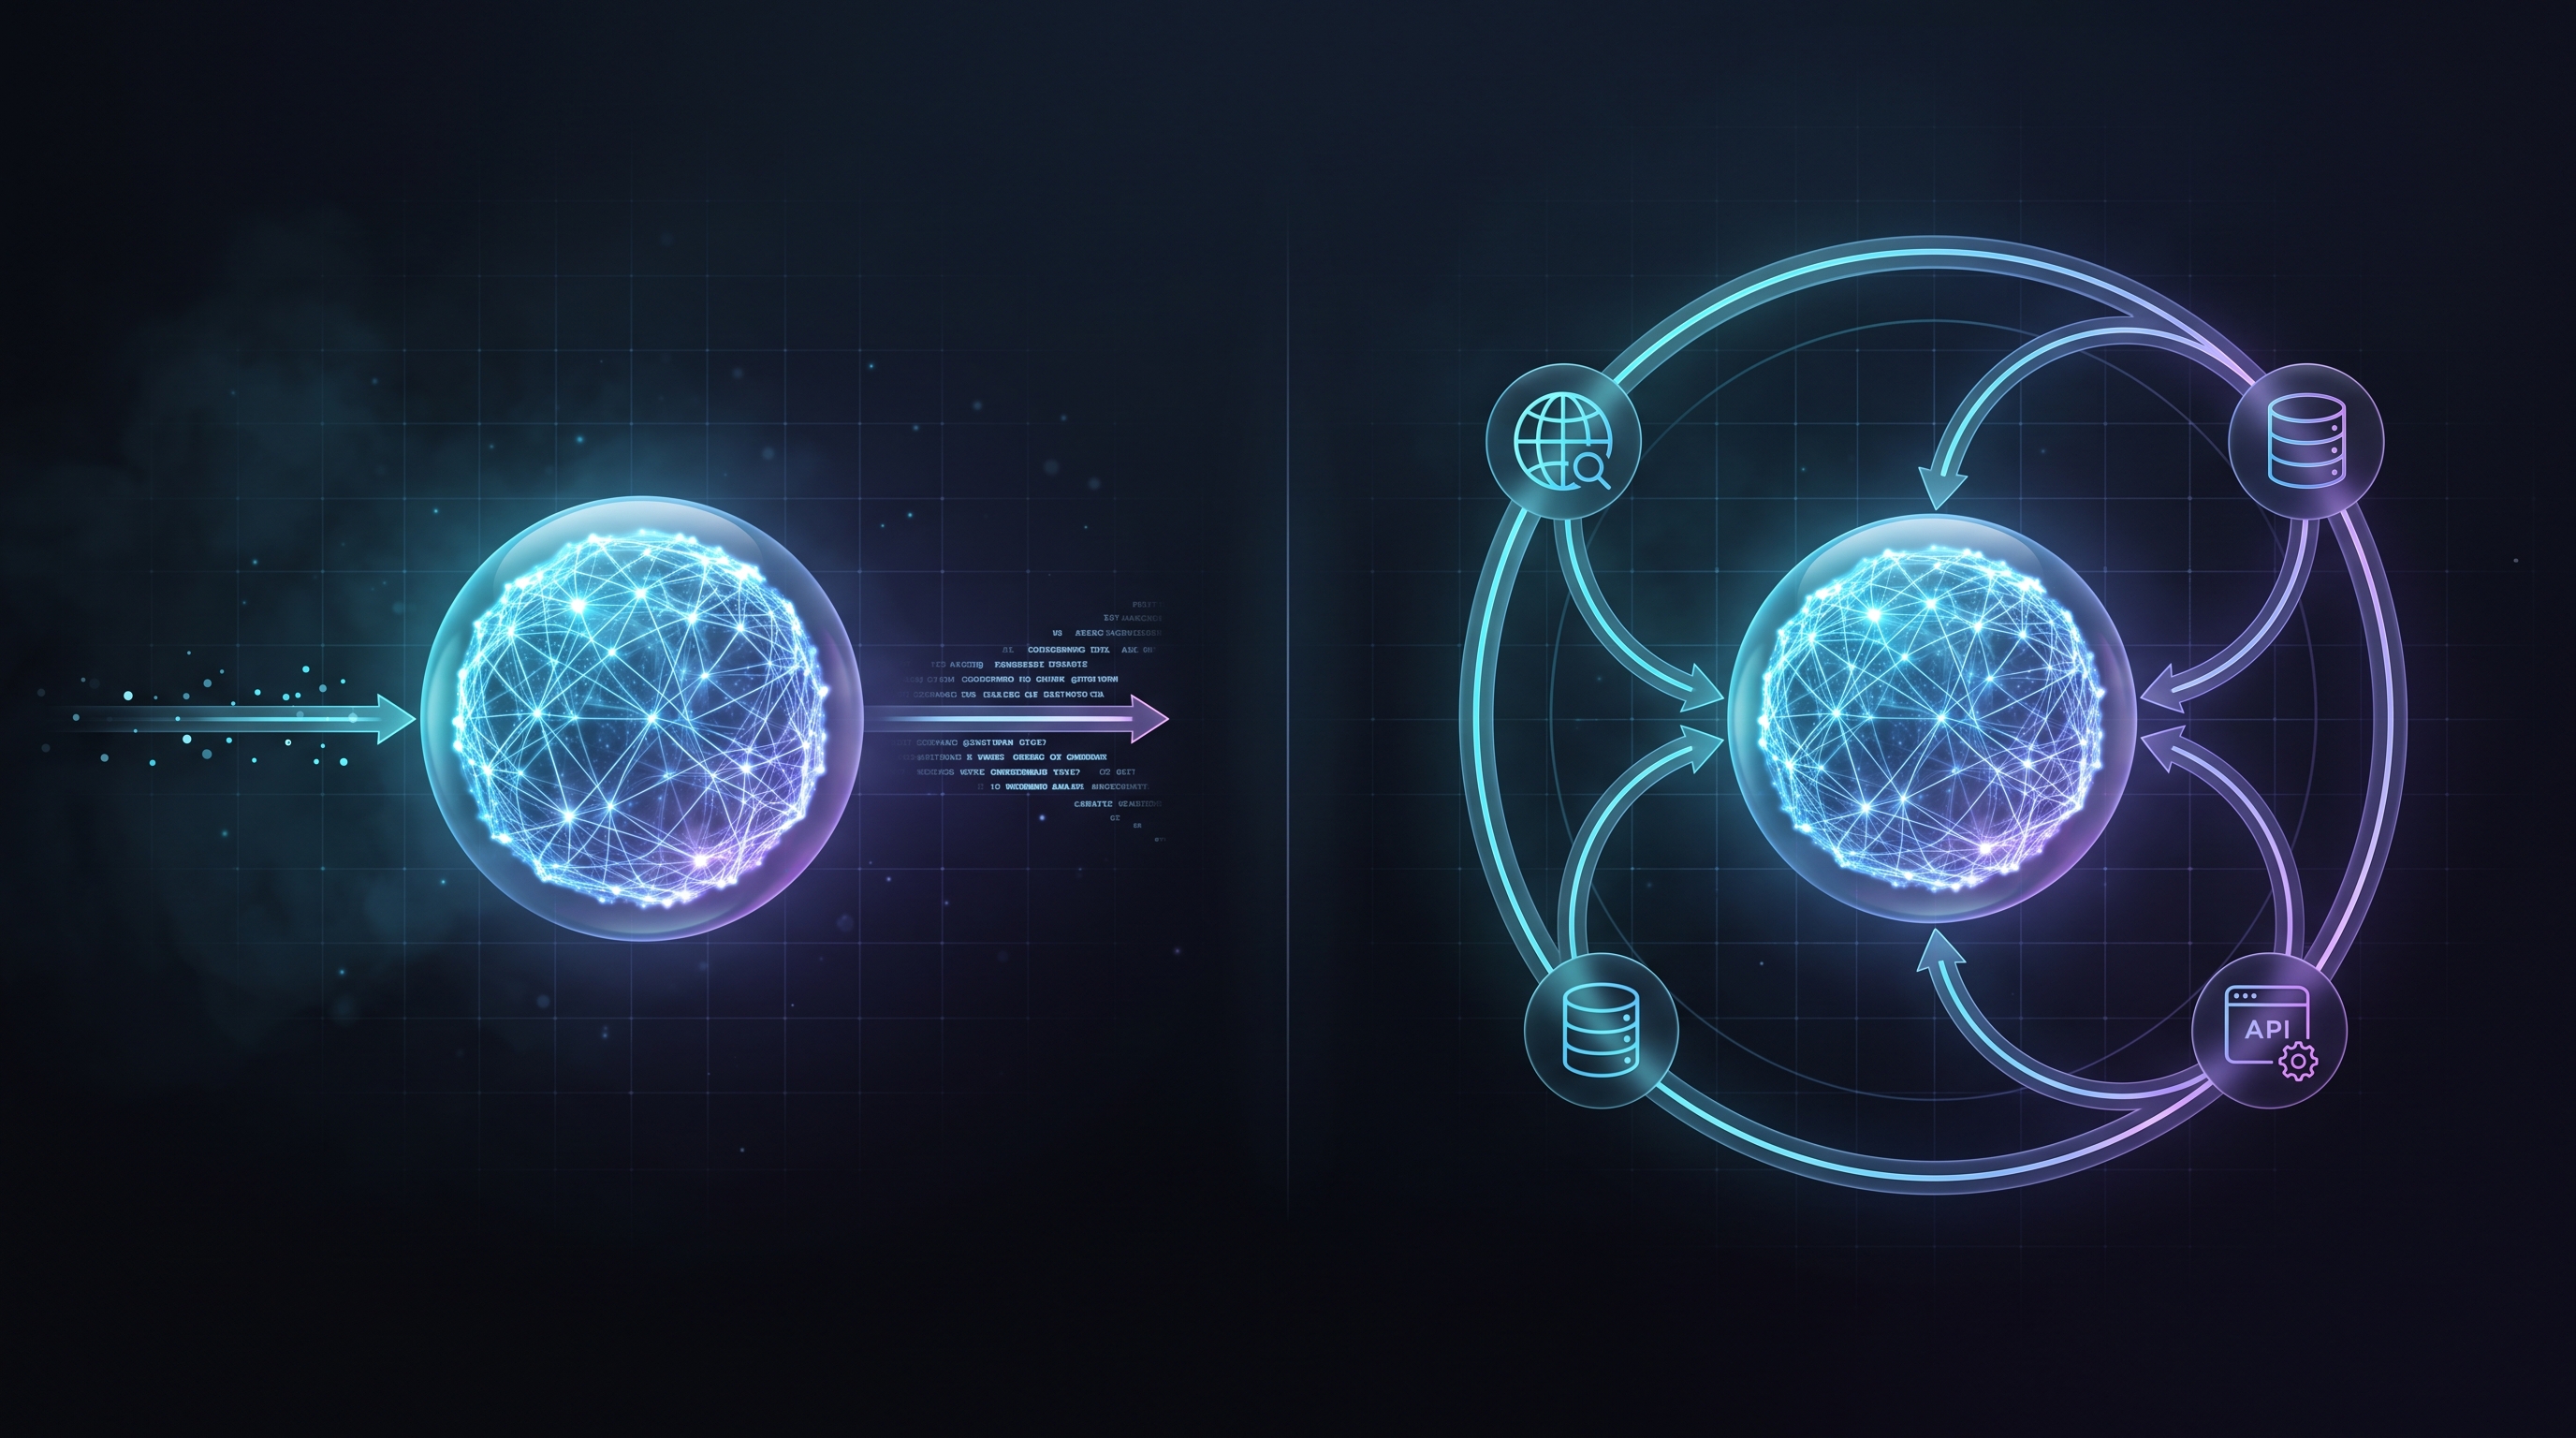
Agent সেই একই prediction engine-কে একটা loop-এর ভেতর বসিয়ে দেয়, আর plain LLM call-এ না থাকা তিনটা জিনিস যুক্ত করে:
- Tools — model যেগুলো নিজে choose করে call করতে পারে (web search, database query, কোনো API hit করা) শুধু text generate করার বদলে।
- Memory — step-এর মধ্যে state carry করার কোনো উপায়, যাতে পঞ্চম decision-টা প্রথম চারটাতে কী হয়েছিল সেটা জানে।
- একটা Loop — এটাই সবচেয়ে বড় জিনিস। Model action নেওয়ার পর, কিছু একটা সেই action-এর result ফিরিয়ে দেয়, আর model আবার decide করে। এটা চলতে থাকে যতক্ষণ না তার কাছে একটা answer থাকে, শুধু একটা completion না।
এই loop-টাই পুরো পার্থক্য। Model না, prompt না, tool নিজেও না — তুমি একটা LLM-কে একটা tool দিয়ে দিতে পারো, আর সেটা request-এ একবারের বেশি call করতে না দিয়ে, তাও তোমার কাছে agent নেই, শুধু একটু smarter একটা single request আছে।
Theory না, code-এ দেখো
এটা একটা plain LLM call। একটা request, একটা response, মাঝখানে আর কিছু না:
// llm-only.ts
import OpenAI from "openai";

const client = new OpenAI();

async function askOnce(question: string) {
  const response = await client.chat.completions.create({
    model: "gpt-4o-mini",
    messages: [{ role: "user", content: question }],
  });
  return response.choices[0].message.content;
}

const answer = await askOnce("What's the capital of Bangladesh?");
console.log(answer);
এখন একই model, একটা minimal agent-এর ভেতর বসানো। একই API, একই account, একই billing — শুধু একটা loop আর একটা tool যুক্ত হয়েছে:
// minimal-agent.ts
import OpenAI from "openai";

const client = new OpenAI();

const tools = [
  {
    type: "function" as const,
    function: {
      name: "get_time",
      description: "Returns the current server time",
      parameters: { type: "object", properties: {} },
    },
  },
];

function getTime() {
  return new Date().toISOString();
}

async function runAgent(question: string) {
  const messages: any[] = [{ role: "user", content: question }];

  while (true) {
    const response = await client.chat.completions.create({
      model: "gpt-4o-mini",
      messages,
      tools,
    });

    const message = response.choices[0].message;
    messages.push(message);

    if (!message.tool_calls) {
      return message.content;
    }

    for (const call of message.tool_calls) {
      const result = call.function.name === "get_time" ? getTime() : null;
      messages.push({
        role: "tool",
        tool_call_id: call.id,
        content: JSON.stringify(result),
      });
    }
  }
}

const answer = await runAgent("What time is it right now?");
console.log(answer);
দ্বিতীয় file-টা একটু ধীরে পড়ো। Model বেশি smart হয়ে যায়নি। Prompt-ও বেশি clever হয়নি। একমাত্র structural পরিবর্তন হলো একটা while loop, যেটা model-কে tool call করতে দেয়, result দেখতে দেয়, আর answer দেওয়ার আগে আবার decide করতে দেয়। এই loop-টাই "LLM ব্যবহার করা" আর "একটা agent চালানো"-র মধ্যে পুরো দূরত্ব।
Architecture, এক ছবিতে
flowchart LR
    A[User একটা question করলো] --> B{LLM decide করছে}
    B -->|আরো info লাগবে| C[একটা Tool call করলো]
    C --> D[Tool থেকে result আসলো]
    D --> B
B -->|answer দেওয়ার জন্য যথেষ্ট| E[Final answer ফিরলো]Flow summary (বাংলা): User-এর question LLM-এর কাছে যায়, LLM decide করে সরাসরি answer দেওয়া যাবে নাকি আগে একটা tool call লাগবে; tool call করলে সেই result আবার LLM-এর কাছে ফিরে আসে, আর এই চক্র চলতে থাকে যতক্ষণ না model-এর কাছে final answer দেওয়ার জন্য যথেষ্ট information থাকে।
আমার প্রথম "agent" বানানোর ভুলটা
আমার বানানো প্রথম "agent"-টা আসলে agent-ই ছিল না। একটা chat completion call-কে একটা for-loop-এর ভেতর বসিয়ে দিয়েছিলাম, যেটা model প্রথম answer-এ satisfied না হলে সামান্য অন্যভাবে prompt সাজিয়ে বারবার একই question জিজ্ঞেস করতো। প্রথম দশ মিনিট এটাকে জাদুর মতো লাগছিল, কারণ retry-তে answer সত্যিই একটু ভালো হচ্ছিল। তারপর logs-এ actually কী হচ্ছে সেটা দেখলাম: কোনো tool call নেই, iteration-এর মাঝে কোনো state carry হচ্ছে না, real world-এর সাথে কিছুই check হচ্ছে না। এটা একই model, একই static prompt-এ দ্বিতীয়-তৃতীয়বার একটু ভালো guess করছিল মাত্র। আমি একটা retry loop বানিয়ে সেটাকে agent বলে ডাকছিলাম।
যেটা আসলে আমার mental model পুরো বদলে দিয়েছিল, সেটা হলো একটা real tool যুক্ত করা — খুব fancy কিছু না, শুধু একটা function যেটা একটা API hit করে একটা JSON result ফিরিয়ে দেয় — আর দেখা যে model নিজে সেটা call করার সিদ্ধান্ত নিচ্ছে, result পড়ছে, আর তার ভিত্তিতে পরের message বদলে দিচ্ছে। ঠিক সেই মুহূর্তেই একটা wrapped API call আসলেই কিছু "decide" করা শুরু করে, শুধু generate করা না।
মানুষ যখন বলে "আমি একটা agent বানিয়েছি" — সবচেয়ে common ভুলগুলো
- একটা tool-enabled call-কেই agent বলে ধরে নেওয়া। Model tool call করতে পারলেও যদি code-এ request-এ একবারের বেশি call করার সুযোগ না থাকে, তাহলে তুমি একটু smarter একটা API call বানিয়েছ, agent না — loop না থাকলে model-এর course বদলানোর কোনো জায়গা নেই।
- লম্বা system prompt-কে autonomy ভেবে নেওয়া। ২,০০০ শব্দের একটা instruction-ভর্তি system prompt নিজে থেকে কিছু decide করে না; সেটা শুধু প্রতিটা individual response-কে বেশি constrained করে।
- Memory স্কিপ করে সেটাকে "context" বলা। প্রতিবার একই static chat history ফিরে পাঠানো memory না — real agent memory মানে system একটা আগের run থেকে কিছু save করছে, আর সেটা পরের, আলাদা একটা run-এ ফিরিয়ে আনছে।
- বেশি tool মানেই বেশি capability ভেবে নেওয়া। পনেরোটা tool আর একটা খারাপ loop থাকা একটা model, দুইটা tool আর একটা clean loop থাকা model-এর চেয়ে বেশি জায়গায় আটকে যাবে। Tool-এর সংখ্যার চেয়ে loop-এর design বেশি matter করে।
কখন plain LLM call-ই আসল সঠিক choice
সব জায়গায় agent বানানো লাগবে না। একটা static FAQ answer করা, একটা lookup, একটা single-step translation — এইসব কাজে plain LLM call বেশি fast, বেশি predictable, আর debug করা সহজ। Agent loop যখন দরকার নেই তখনও বানিয়ে ফেলা — এটাও তেমনই একটা common ভুল, ঠিক উপরের গুলোর মতোই।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলী (FAQ)
LLM দিয়ে বানানো প্রতিটা chatbot-ই কি AI Agent? না। Chatbot যদি একটা message নিয়ে একটা response ফিরিয়ে দেয়, আর result দেখে কোনো action নেওয়ার decision না নেয়, তাহলে সেটা একটা সুন্দর করে সাজানো LLM call, agent না।
Agent বানাতে কি LangChain-এর মতো framework লাগবেই? না — উপরের দুটো code sample-ই একটা agent-এর জন্য minimum যা লাগে তার পুরোটা: একটা model, একটা tool, আর একটা loop। Framework বড় system-এর জন্য convenience যুক্ত করে, concept-টা যুক্ত করে না।
একটা plain LLM কি সময়ের সাথে নিজে থেকেই agent হয়ে যেতে পারে, কোনো extra code ছাড়া? না। Model নিজে বদলায় না; যেটা বদলায় সেটা হলো তার চারপাশে বানানো system। LLM নিজে থেকে কখনো loop করা বা tool call করা শুরু করে না — সেই structure-টা বানিয়ে দিতে হয়।
কাস্টম ওয়েব অ্যাপ বা এআই অটোমেশন বানাতে চান?
আমি স্টার্টআপ ও আধুনিক ব্যবসার জন্য স্কেলেবল ফুল-স্ট্যাক ওয়েব অ্যাপ্লিকেশন (Next.js, React, Node, PostgreSQL) এবং ইন্টেলিজেন্ট এআই এজেন্ট সলিউশন তৈরি করি। আপনার প্রজেক্টের আইডিয়া নিয়ে কথা বলা যাক!
আর্টিকেলটি কি আপনার ভালো লেগেছে?
তন্ময়ের কাজকে সাপোর্ট করতে তালি (Clap) দিয়ে উৎসাহিত করুন!
জাহিদ হাসান তন্ময়
সফটওয়্যার ডেভেলপার
MERN ফুল-স্ট্যাক ডেভেলপার এবং AI এজেন্ট ডেভেলপার, ঢাকা, বাংলাদেশ। ওয়েব ডেভেলপমেন্ট, রিঅ্যাক্ট, লারাভেল এবং আমার লার্নিং জার্নি নিয়ে লিখছি।